
AIでワクワク体験を!
東京大学発パラレルスタートアップ
私たちは、AIを使って様々なことに挑戦する人や企業・官公庁を応援します
そのなかで、個人・グループ単位で成長を後押しする知識や体験を提供し、
ウェルビーイングな毎日を過ごせるインクルーシブ社会の実現を目指します
News
ニュース
お知らせ
2026/10/07
お知らせ
2026/09/28
お知らせ
2026/08/16
Service
サービス
Business
法人・官公庁のお客さま
知性を、組織の力へ。 変革の先にある、新しい価値をともに創る
組織の本質的な課題に深く寄り添い、心地よく調和する独自のAI・DXソリューションをともに実現します。
AXコンサルティング『Lifeco-biz』
法人・官公庁の成長を、一緒にデザインしてみませんか?
大手企業のAXコンサルティング及び自治体のDX内製化の経験を持つメンバーが、個人向けライフコーチングを応用したカウンセリングも導入し、飛躍的な成長を後押しします。
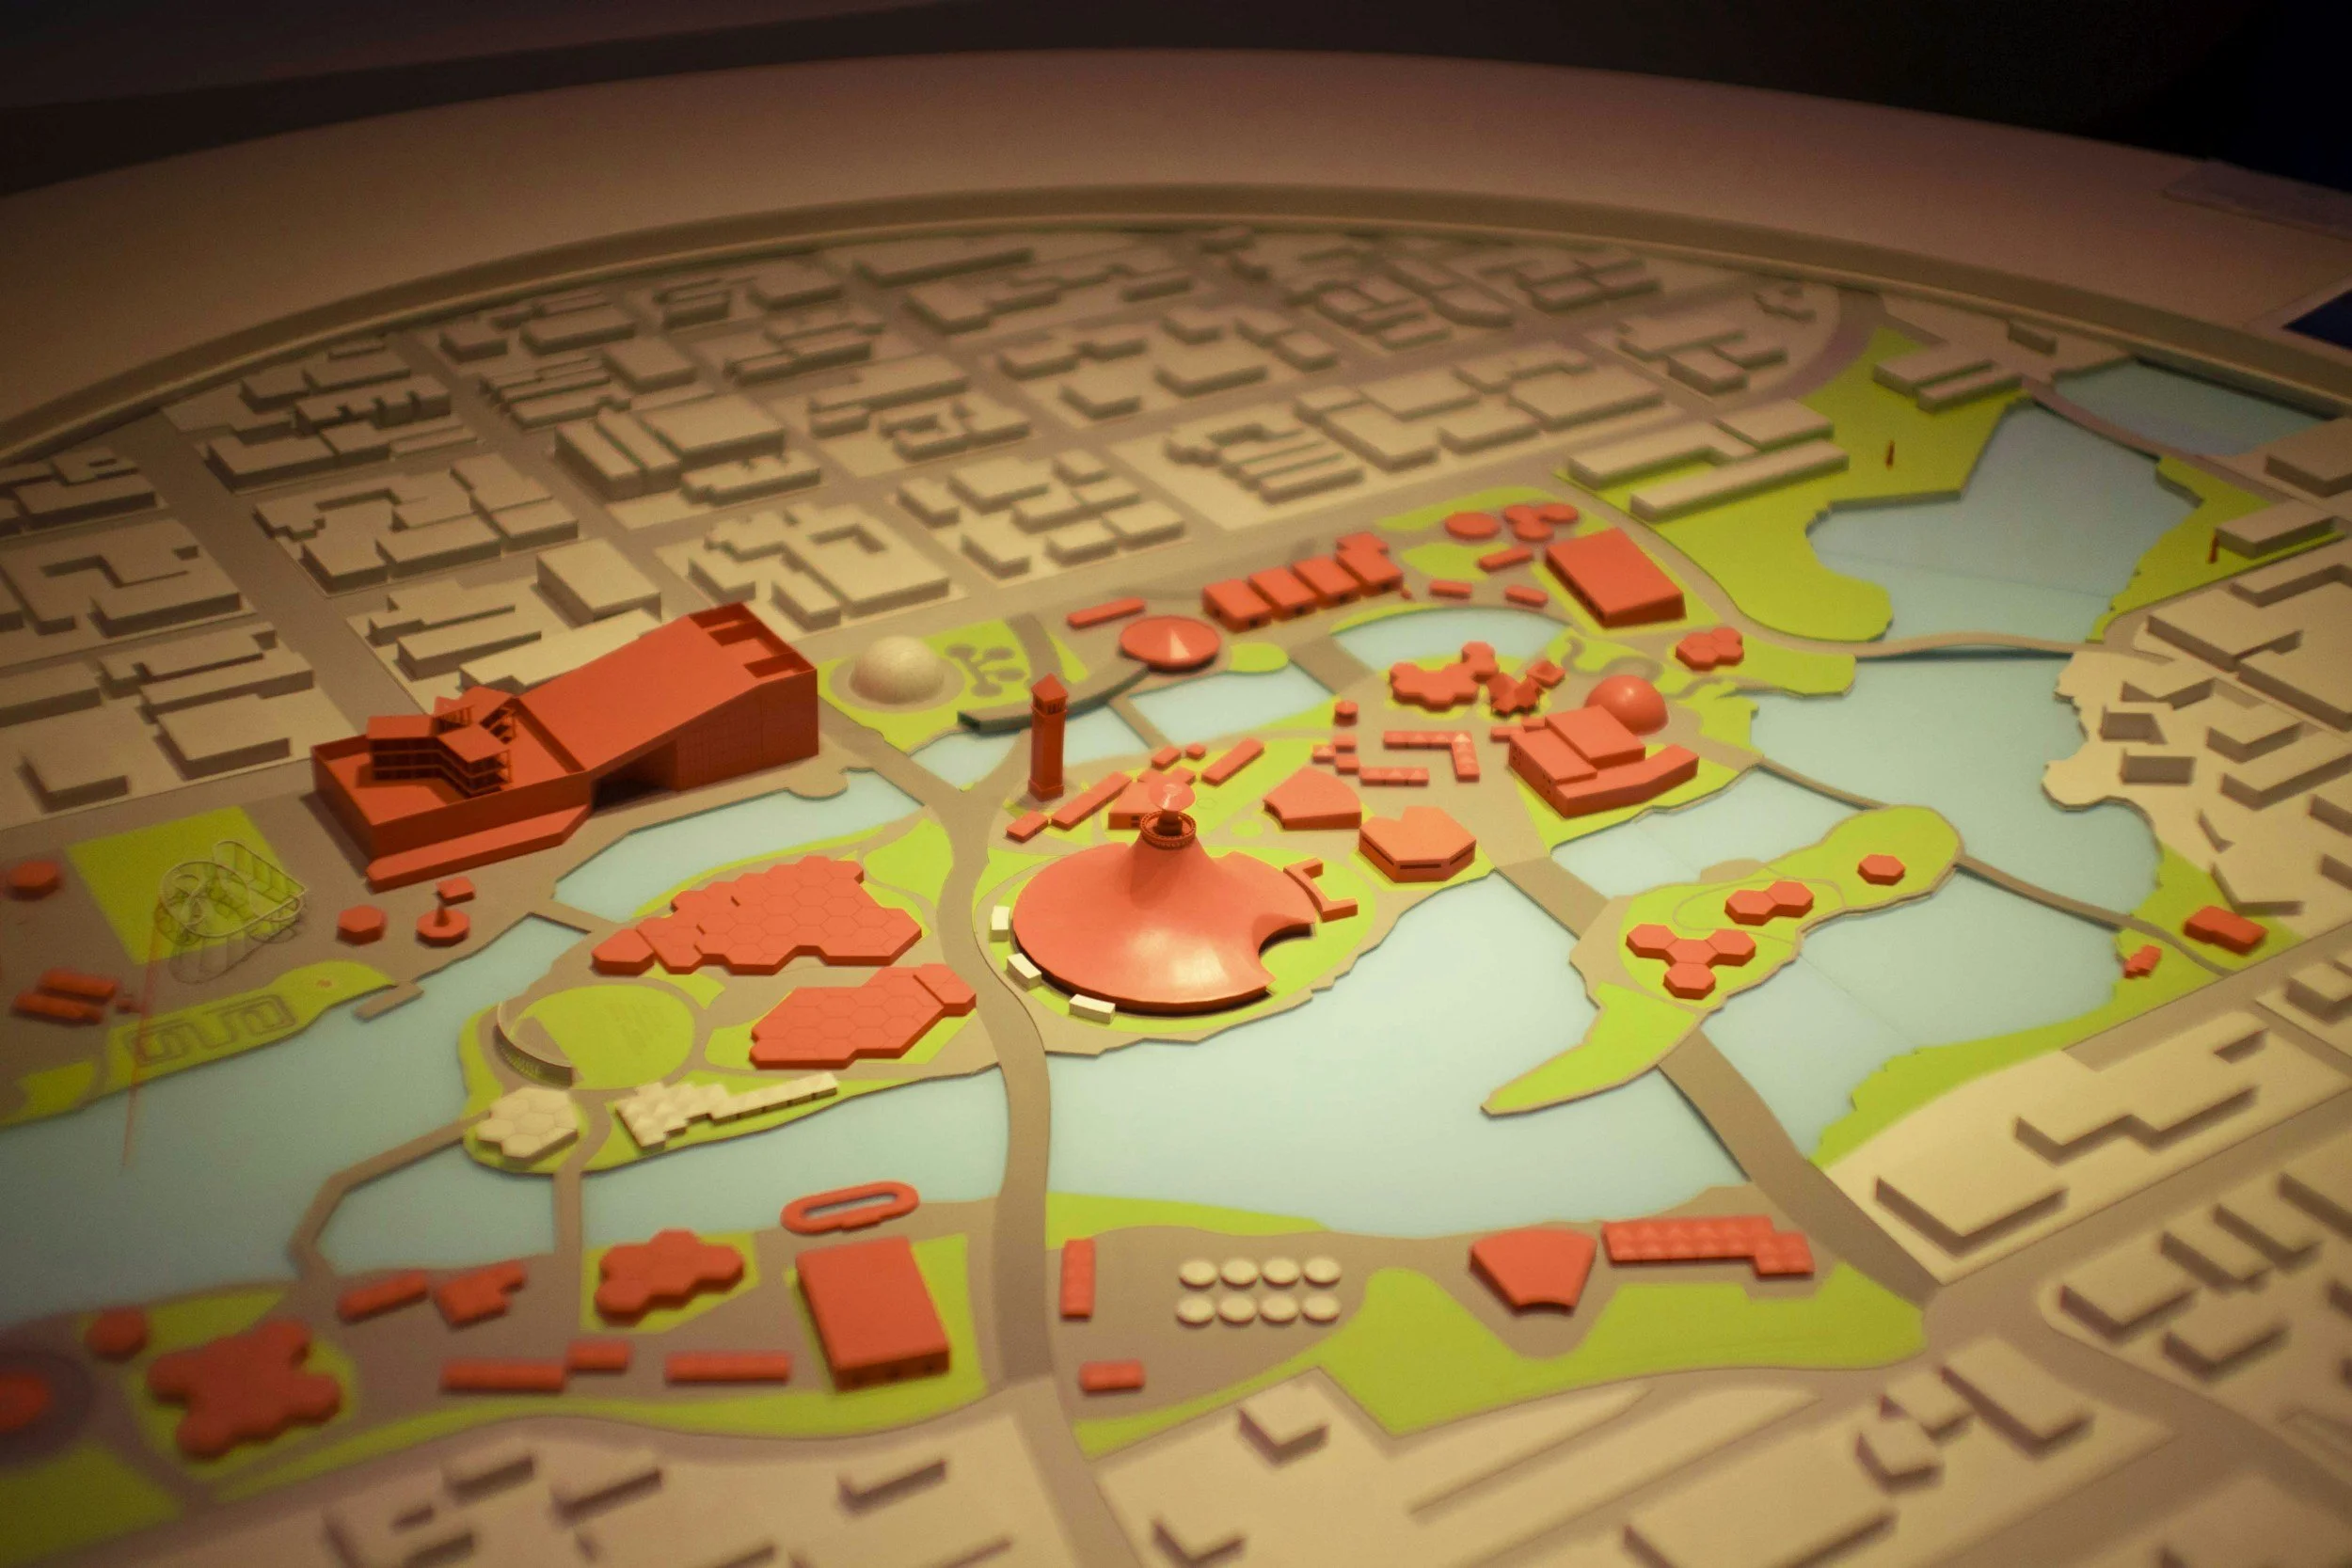
3D地図生成『Geotowa-biz』
3D地図で観光産業・不動産業界を盛り上げませんか?
大学院で3D地図生成の研究をしていた経験を持つメンバーにより、360度カメラからの映像のみで3Dの高精細地図を自動生成するソリューションを提供します。
Personal
個人のお客さま
一歩を踏み出す、その軌跡に寄り添う。あなたの「やりたい」を、ここから形に
ライフコーチングや共育メディアを通じて、年齢を理由に諦めないワクワクする挑戦に二人三脚で伴走します。
ライフコーチング『Lifeco-me』
自分の人生を、一緒にデザインしてみませんか?
心理学に基づくカウンセリングと丁寧な対話を通じて、あなたの特性を活かしたワクワクする未来を二人三脚で形にします。
コーチー(Coachee)
メンター(Mentor)
夢追うメディア『愛湧く』
夢追う軌跡を、等身大の言葉で紡ぐ
さまざまな挑戦や人生のライフログを動画やストーリーで共有し、ともに学び合い、一歩を踏み出す勇気を育む共育の場を創ります。


AXブログ『Axconet』
AIが拓く未来を、もっと身近に、深く
AI・DXの最新トレンドや実践的な活用知見をわかりやすく紐解き、個人と組織の変革を後押しするナレッジを発信します。
Englishブログ『Amichat』
言葉と文化を超えて、知性と想いを世界へつなぐ
AIやウェルビーイングなど、英語起点の多様な挑戦に関する知見を発信し、世界中の人々とともに学び深め合うグローバルな対話の場を創ります。
Business Overview
事業紹介
ウェルビーイング事業
01
自分らしく、心地よく、あたたかに
心にそっと寄り添い、健やかな毎日を守る
私たちは、最新のテクノロジーを「心の内なる幸せ」のために正しく調和させることを目指しています。
個人のお客さまへ向けた自発的な学びを育む『共育コミュニティ』や『ライフコーチング』はまさにそれを体現しています。
さらに、現在日々のストレスや不安にそっと寄り添う「メンタルヘルスケアのためのAIチャットアプリ」の開発を進めています。
機械的な処理ではなく、一人ひとりの心の温度を感知し、そっと包み込むようなあたたかな体験を通して、誰もが自分らしさを祝福され、健やかな心で毎日を過ごせるインクルーシブな社会を創造します。
アグロエコロジー事業
02
大地の営みに学び、テクノロジーで未来を紡ぐ
生命の循環を、次の世代へ手渡すために
生態系と調和しながら持続可能な食と農をデザインする「アグロエコロジー」。
私たちは、土や植物といった自然が持つ本来の生命力を、最新のスマート農業技術や遺伝子工学などの科学的知見と掛け合わせ、地球と人が共生できる新しい農業の形を追求しています。
自ら土に触れ、作物を育てる実直な体験から得た知恵をもとに、持続可能で豊かな食の未来と、すこやかな循環社会を創造します。
ナレッジ事業
03
「知る」から「変わる」へ、ともに歩みを進める
人生を、そして社会を前進させる確かな知性
私たちは、東京大学発のパラレルスタートアップとして、最先端の知性と実践的なアイデアを掛け合わせ、人や組織の可能性を最大化する「ナレッジ」を共有しています。
個人のお客様へ向けた一人ひとりの夢と挑戦のプロセスを丁寧に紡ぐメディア『愛沸く』。
そして法人のお客さまへの『AI・DXコンサルティング・ソリューション開発』。
一方的な情報提供にとどまらず、ともに問い、ともに成長し合う本質的な知恵を提供し続けます。
Aiwak Blog
Aiwak ブログ
中国アリババ社が公開した1,250億(125B)パラメーター・約80GBのオープンウェイト大型モデル「Qwen 3.8 Flash Next」が、なぜ12GB(さらには8GB)の家庭用GPU1枚で高速動作するのかを技術的に解説。従来のように「VRAMにモデル全体系を収める」固定観念を脱却し、推論エンジン「Strata(ストラタ)」が採用した「VRAM(GPUデスク)・メインメモリ(書架)・SSD(目録)」という階層的メモリ割り当てと、小型助手による「投機的デコード(Speculative Decoding)」の仕組みを紐解きます。
要約
[01:10]80GBのモデルが12GB/8GBのグラボ(VRAM)で動く理由と「Strata(ストラタ)」の基本原理
VRAM容量制限を打破し、ゲーミングPC(RTX 5070 / RTX 4060 Laptop)で125Bモデルが動作する衝撃的ベンチマーク結果を共有しています。
[04:53]図書館で例える「VRAM・メインメモリ・SSD」の階層的メモリ活用メカニズム
VRAM(直近で使う専門家)、RAM(全専門家の保持)、SSD(目録)に役割分担し、「VRAMに入りきらない前提」で動かす発想転換を解説しています。
[09:37]加速のキーテクノロジー「投機的デコード(Speculative Decoding)」と予測の仕組み
小型エージェントが次に続く数トークンを先行予測し、大型本体が一括検証することで読み書き往復のオーバーヘッドを劇的に削る技術を説明しています。
[11:36]本当に必要な機材投資はGPU(VRAM)ではなく「メインメモリ(64GB RAM)」
VRAM買い替え競争から脱却し、メインRAMを64GBに拡張することがローカルLLM推論の真のボトルネック解消になる実態を明かしています。
[17:11]ローカルLLM推論の現状の課題・制限事項(単一セッション・長期コンテキスト再読み込みなど)
1人用(シングルセッション)限定や量子化(3bit付近)に伴う応答品質の未検証性、長時間対話での下読み再実行といった制約を整理しています。
【Aiwakからの視点】
本動画で解説された「Strata」の手法は、「高価なデータセンター向けGPU(H100/A100)の専売特許であった超大型モデル推論」を「コンシューマー向け既存ハードウェア」へ解放する歴史的なインフラ的パラダイムシフトを意味しています。
特筆すべきは、単なるVRAM競合の力技ではなく、MoE(Mixture of Experts)の疎性(Sparsity)に着目し、活性化する重み(60億パラメーター分)のみをCPU(メインRAM)とGPU(VRAM)の階層間でオフロード・パイプライン化し、投機的デコードでレイテンシを打ち消す設計思想です。高価なグラボを買い替えることなくメインメモリ(64GB RAM)の増設のみで100B超モデルが自律駆動する世界観は、エッジAIやプライベート・ローカルLLM環境の構築において(Aiwak的観点における)極めて実用的でインパクトの大きいイノベーションと言えます。